Ouvrez n’importe quelle réponse générée par une IA et regardez ce qu’elle contient : quelques lignes, deux ou trois liens. Les pages citées, elles, en font des centaines. Entre la page et la réponse, quelque chose a été retenu et tout le reste écarté. La question utile n’est donc pas « mon entreprise est-elle assez connue », mais « existe-t-il sur mon site un paragraphe qui répond seul à la question posée ».
Cette nuance décide de presque tout. Elle explique pourquoi un site bien classé dans les résultats classiques peut n’être jamais repris dans une réponse générée, et pourquoi une page modeste l’est régulièrement.
A considérer
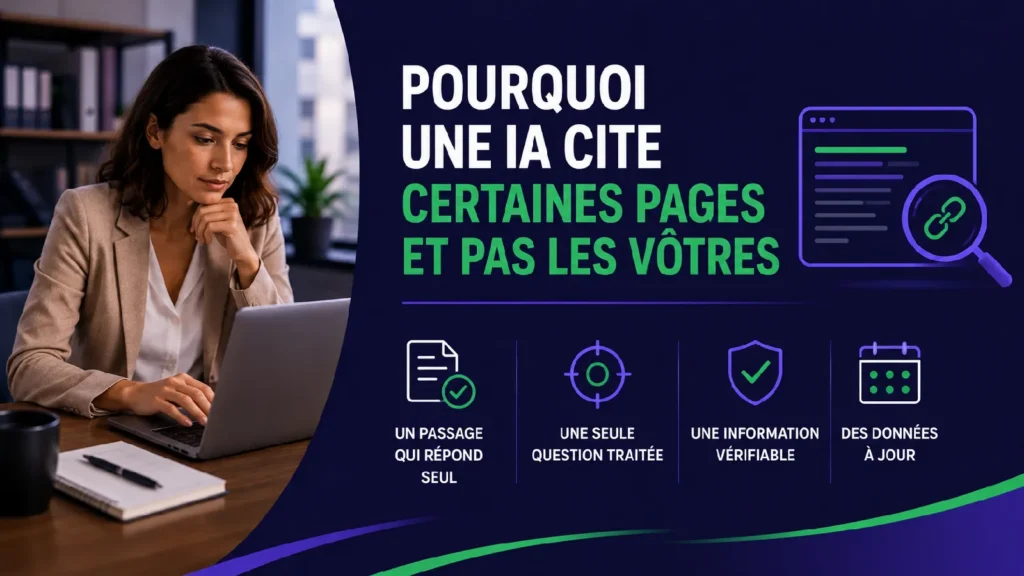
Une réponse générée fait quelques lignes là où les pages qu’elle cite en font des centaines : ce qui se joue est donc moins la page que le passage qui répond. Un passage qui tient seul traite une seule question, se comprend hors de son contexte, nomme explicitement le sujet au lieu de le sous-entendre, et porte une donnée vérifiable. Trois obstacles techniques écartent en amont : un contenu construit par le navigateur, des robots bloqués, une information enfermée dans une image ou un fichier joint. Google écrit qu’une page doit être indexée et éligible à un extrait pour figurer en lien d’appui dans ses réponses IA. La vérification se fait ensuite question par question, moteur par moteur, à intervalle régulier, et elle se consigne.
Ce qui change quand la réponse arrive avant les liens
Le principe est simple à énoncer. Quand un moteur affiche une réponse rédigée au-dessus des résultats, ou quand un assistant répond directement dans une conversation, l’utilisateur obtient ce qu’il cherchait sans ouvrir de page.
La conséquence se comprend sans instrument : quand la réponse suffit, le clic ne part pas. Votre contenu peut alimenter une réponse lue par des centaines de personnes sans qu’aucune ne visite votre site. Vous perdez la visite, mais vous conservez la mention, à condition d’être cité.
C’est le déplacement à comprendre. L’enjeu n’est plus seulement d’être trouvé, il est d’être repris. On désigne parfois ce travail par l’acronyme GEO, pour generative engine optimization. Le mot est nouveau, le raisonnement l’est beaucoup moins : il s’agit toujours de rendre une information facile à trouver, facile à extraire et facile à attribuer.
Un point mérite d’être posé tout de suite, parce qu’il évite des dépenses inutiles. Personne ne vend une garantie de citation. Ni un prestataire, ni un outil. Une promesse de résultat garanti est au contraire l’un des signaux qui font écarter une proposition, comme le rappelle notre guide sur reconnaître une proposition SEO tenable. Ce qui suit augmente la probabilité d’être repris et rend le résultat observable. C’est différent d’une promesse.
Ce qui est repris n’est pas toute la page
Il faut poser une limite avant d’aller plus loin, parce qu’elle disqualifie l’essentiel de ce qui s’écrit sur le sujet. Aucun éditeur de moteur de réponse ne publie la façon dont ses systèmes découpent une page, ni les critères qui font retenir un passage plutôt qu’un autre. Les schémas qui circulent sont des reconstructions.
Ce que Google en dit est plus étroit, et suffit à travailler. Ses systèmes peuvent extraire d’eux-mêmes un passage d’une page pour l’afficher, et l’éditeur du site n’a pas la main sur celui qui sera retenu : interrogé sur la façon de désigner son propre extrait, Google répond qu’on ne peut pas. Il décrit par ailleurs, pour ses fonctionnalités IA, une technique de recherches lancées en éventail : une seule question posée par l’utilisateur en déclenche plusieurs, liées. Une page peut donc être atteinte par une formulation que personne n’a tapée.
Deux conséquences d’écriture, et aucune ne suppose de savoir ce qui se passe à l’intérieur. La première : puisque le passage retenu ne se choisit pas, plusieurs endroits de la page doivent être également défendables. La seconde : un texte qui progresse comme une démonstration, où chaque paragraphe suppose le précédent, n’offre aucun endroit qui tienne debout seul.
Cela renverse une habitude d’écriture. Un texte bien construit pour un lecteur humain pose un décor, développe, puis conclut. Un texte utilisable ailleurs doit pouvoir être ouvert n’importe où.
Le test est immédiat. Prenez un paragraphe de votre page, retirez tout ce qui l’entoure, et lisez-le. S’il commence par « ce dernier », « comme vu plus haut » ou « dans ce cas précis », il est inexploitable hors contexte. Si le sujet dont il parle n’est pas nommé mais seulement rappelé par un pronom, il l’est tout autant.
Les cinq propriétés d’un passage qui tient seul
L’essentiel du travail tient dans cinq propriétés. Aucune n’est une astuce technique, et aucune ne repose sur une hypothèse concernant les moteurs : elles se vérifient toutes en détachant un paragraphe de sa page et en le relisant.
| Propriété | Ce que cela veut dire concrètement |
|---|---|
| Autonomie | Le paragraphe se comprend seul, sans le précédent ni le suivant. Le sujet y est nommé, pas rappelé par un pronom. |
| Unicité | Une question, un passage. Un paragraphe qui traite le prix, le délai et la garantie ensemble n’est la réponse propre à aucune des trois questions : celui qui n’en cherche qu’une doit trier. |
| Antériorité de la réponse | La réponse figure dans les deux premières phrases. Ce qui vient ensuite justifie, nuance, illustre. |
| Vérifiabilité | Le passage porte un chiffre, une condition, une durée ou une règle. Une appréciation qualitative se reprend mal : elle ne dit rien que n’importe lequel de vos concurrents ne puisse écrire aussi. |
| Datation implicite | Une donnée susceptible de changer indique sa période de validité. Un chiffre sans date se périme sans prévenir et affaiblit tout le reste. |
La deuxième propriété est celle qui coûte le plus d’efforts, parce qu’elle contredit une habitude commerciale. On veut tout dire au même endroit, pour convaincre d’un bloc. Or une question posée à un assistant est presque toujours une question unique. Le bloc qui répond à tout n’est la réponse propre à aucune.
Ce que la structure de la page change
La mise en forme ne prouve rien sur ce qu’un moteur retiendra, et il faut résister à la tentation de le croire : Google est explicite sur le fait que la sélection lui appartient. Elle change en revanche quelque chose que vous pouvez contrôler, vous.
Un intitulé de section formulé comme une question, suivi immédiatement de sa réponse, rend le passage lisible isolément : détaché du reste de la page, il porte encore sa question et sa réponse. Un intitulé du type « Nos atouts » ou « En savoir plus » ne dit pas de quoi parle ce qui suit, et le passage détaché ne se comprend plus. C’est ce test-là qui justifie l’effort, pas une hypothèse sur la façon dont le texte est découpé.
Les tableaux et les listes courtes ont un avantage particulier. Ils rendent les relations explicites : telle valeur correspond à tel poste, telle condition à tel cas. Là où une phrase longue laisse une ambiguïté grammaticale, une ligne de tableau n’en laisse aucune.
La cohérence interne compte également. Si le même chiffre apparaît sous trois formes différentes sur trois pages du site, vous publiez trois versions concurrentes du même fait. Rien ne désigne la bonne : ni pour une machine, ni pour un lecteur qui prend la peine de recouper. Un fait, une formulation, partout.
Reste le balisage de données structurées. Rien ne permet d’affirmer qu’il déclenche une citation, et personne ne devrait le vendre ainsi. Il sert autre chose, et c’est utile : lever les ambiguïtés d’identité, en déclarant proprement qui vous êtes, ce que vous vendez, où vous exercez, sous quel nom vous êtes connu ailleurs. C’est un travail d’état civil, pas un levier de performance.
Les trois obstacles qui vous excluent avant même l’évaluation
Il arrive qu’un contenu remplisse toutes les conditions et ne soit jamais cité, pour une raison qui n’a rien à voir avec l’écriture. Trois causes reviennent.
Le contenu n’est pas dans la page servie. Le contrôle prend dix secondes : affichez le code source d’une page de service, copiez une phrase visible à l’écran, cherchez-la dans la source. Si elle n’y figure pas, le texte est construit par le navigateur. Cela n’exclut pas Google, qui documente une phase de rendu où un navigateur exécute le JavaScript avant l’indexation, mais il précise aussi que ce rendu passe par une file d’attente, donc par un délai, et que tous les robots n’exécutent pas le JavaScript. Ce qui est absent de la source n’est donc garanti à personne, et le point se note.
Les robots sont bloqués, ou ce ne sont pas ceux que vous croyez. Les principaux éditeurs publient les noms de leurs robots et l’usage de chacun, et cet usage diffère d’un robot à l’autre chez un même éditeur. OpenAI documente ainsi que bloquer GPTBot signale que le contenu ne doit pas servir à entraîner ses modèles, tandis qu’un autre robot, OAI-SearchBot, conditionne l’apparition dans ses résultats : les sites qui le bloquent n’y figurent pas. Autoriser l’un n’autorise donc pas l’autre, et le fichier robots.txt mérite une lecture ligne à ligne, documentation de chaque éditeur ouverte à côté.
Une réserve à garder en tête, et elle est de taille : la déclaration d’un robot n’est pas une garantie de comportement. Cloudflare a rapporté que le robot de Perplexity, une fois bloqué, basculait sur un navigateur générique se faisant passer pour Chrome sur macOS, changeait d’adresses IP et ignorait le robots.txt sur des dizaines de milliers de domaines. Ce fichier exprime une consigne, il n’impose rien. Qui passe réellement chez vous se lit dans les journaux de votre serveur, pas dans la documentation.
L’information est enfermée. Un tarif dans une image, un comparatif dans un fichier joint, une réponse derrière un formulaire ou un compte : dans les trois cas, l’information existe pour vous et pas pour la machine. Ce qui doit être cité doit être en texte, sur une page accessible sans condition.
Ces trois vérifications se font en une heure. Elles précèdent tout travail d’écriture, parce qu’aucune qualité rédactionnelle ne compense un contenu invisible.
Ce que les autres pages disent de vous
Voici la partie que l’on maîtrise le moins, et qu’il faut connaître avant de s’engager.
Commençons par ce que personne ne sait. Aucun éditeur ne publie la composition de ce sur quoi ses modèles ont été entraînés, ni la liste des sources qu’il privilégie au moment de répondre. Toute affirmation sur les sites que « les IA préfèrent » est invérifiable, y compris quand elle sonne juste.
Ce qui est vérifiable tient dans une manipulation, et elle prend une minute : posez à un assistant une question de votre métier, puis regardez la liste des sources citées sous la réponse. Sur les questions comparatives du type « quelles entreprises font tel métier », il arrive fréquemment que les liens pointent vers des annuaires, des comparateurs ou des pages de classement plutôt que vers des sites d’entreprise. Fréquemment ne veut pas dire toujours, et c’est exactement ce que le relevé décrit plus bas sert à mesurer sur vos requêtes à vous, plutôt qu’à supposer.
Deux conséquences pratiques. La première : ce que ces pages disent de vous, vous ne l’avez pas écrit. Une fiche périmée dans un annuaire, un ancien nom commercial, une adresse abandonnée restent en ligne et restent lisibles longtemps après que vous les avez oubliés. Les mettre à jour fait partie du travail, au même titre que vos propres pages, et cette tâche ne dépend d’aucune hypothèse sur le fonctionnement des moteurs : une information fausse publiée sur vous reste une information fausse publiée sur vous.
La seconde : quand ce sont ces pages qui sont citées, être absent d’elles revient à être absent de la réponse, quelle que soit la qualité de votre site. D’où l’intérêt de savoir lesquelles reviennent, avant de décider quoi que ce soit.
Comment vérifier concrètement si vous êtes cité
La vérification est manuelle, et c’est une bonne nouvelle : elle ne demande aucun budget d’outillage pour commencer. Elle demande de la régularité.
Constituez une liste de questions, pas de mots-clés. Vingt à trente formulations telles qu’un acheteur les poserait à voix haute. Séparez celles qui contiennent votre nom de celles qui ne le contiennent pas : ce sont deux mesures différentes, et la seconde est la seule qui parle d’acquisition.
Posez chaque question dans chaque moteur, sans être connecté à votre compte. Un historique de conversation influence la réponse. Pour mesurer ce que voit un inconnu, il faut se placer dans les conditions d’un inconnu.
Notez trois choses par question : votre entreprise est-elle citée, quelles sources le sont à votre place, et quelle page de votre site est reprise le cas échéant. La deuxième colonne est la plus instructive. Elle vous dit exactement où l’attention se trouve.
Répétez à date fixe et gardez la trace. Une réponse générée n’est pas stable : la même question peut donner deux réponses différentes à quelques minutes d’intervalle. Un relevé unique ne prouve rien, une série mensuelle montre une tendance.
Deux mesures complémentaires méritent d’être branchées. Dans votre outil de statistiques, isolez les visites qui arrivent depuis les domaines de ces services : c’est la part visible, et elle sous-estime largement l’exposition réelle. Dans les journaux de votre serveur, regardez si les robots concernés passent, à quelle fréquence, et sur quelles pages. Cette seconde lecture répond à une question que rien d’autre ne tranche : êtes-vous simplement lu.
Ce que ce travail demande en réalité
Il faut être honnête sur la charge. Ce n’est pas un chantier, c’est une routine.
Réécrire les passages qui portent vos réponses clés se fait une fois. Le relevé de citations, la mise à jour des mentions externes, le contrôle des accès robots et le suivi des questions qui apparaissent reviennent chaque mois. Rien de complexe, rien de rapide non plus.
C’est exactement le type de tâche qui se délègue mal en interne, parce qu’elle n’est jamais urgente, et bien à un collaborateur dédié dont c’est le poste. Chez Rouge Hexagone, un collaborateur travaille pour un seul client, jamais partagé, encadré à Antananarivo et piloté par un chef de projet français. Nos équipes parlent parfaitement français, ce qui compte particulièrement ici : le travail porte sur la formulation.
Le cadre est le même pour toutes nos missions : 1 680 € par mois tout inclus, contre environ 4 485 € pour un coût employeur équivalent en France, soit un écart de 62,5 %. Opérationnel en 10 jours, premier mois satisfait ou 0 €, une garantie jamais activée en dix ans, et la liberté de partir à tout moment. Tout ce qui est produit l’est pour votre compte : relevés, contenus, sources et droits vous reviennent. Rouge Hexagone accompagne des entreprises depuis plus de dix ans, avec plus de 90 employés, et compte parmi ses références Foncia, E.Leclerc et le Groupe Atlantic.
Externaliser le suivi de votre visibilité dans les réponses IA
Être cité dans une réponse générée ne dépend pas uniquement de votre position dans Google. Il faut aussi produire des passages autonomes, vérifier que les contenus sont accessibles aux robots, suivre les sources citées et contrôler régulièrement les questions sur lesquelles votre entreprise apparaît. Externaliser ce suivi avec un collaborateur dédié permet de transformer ces contrôles en routine : relevé des citations, optimisation des passages importants, mise à jour des mentions externes et vérification de l’accessibilité des contenus.
Pour assurer cette continuité, le collaborateur suit les mêmes questions et les mêmes pages dans la durée, sans partager son temps entre plusieurs clients. Il travaille depuis nos locaux à Antananarivo, avec un encadrement local et un chef de projet français comme interlocuteur. Les relevés, contenus, sources et droits produits pendant la mission restent votre propriété.
Questions fréquentes
Faut-il refaire tout son site pour être cité ? Non. Le travail porte d’abord sur les dix à quinze passages qui portent vos réponses décisives : ce que vous faites, pour qui, à quel prix, dans quel délai, avec quelles conditions. Le reste du site n’a pas besoin d’être touché.
Bloquer les robots des IA protège-t-il mon contenu ? Cela dépend du robot, et la distinction est documentée. OpenAI indique que bloquer GPTBot signale que le contenu ne doit pas servir à entraîner ses modèles, tandis que bloquer OAI-SearchBot exclut le site de ses résultats de recherche. Les deux gestes n’ont pas le même effet, et un robots.txt écrit d’un bloc les confond. Refuser l’entraînement se défend quand on vend l’accès au contenu lui-même ; bloquer le robot de recherche, quand on vend un service et qu’on utilise le contenu pour se faire connaître, revient à sortir volontairement des réponses.
Comment savoir si une visite vient d’un moteur de réponse ? Par le domaine référent dans votre outil de statistiques. Sachez que cette mesure ne capte que les personnes qui ont cliqué : l’exposition réelle est plus large, et elle ne se lit pas dans les visites.
Ce travail remplace-t-il le référencement classique ? Non, il s’y ajoute. Google l’écrit noir sur blanc pour ses propres fonctionnalités : pour figurer en lien d’appui dans un aperçu IA ou dans le mode IA, une page doit être indexée et éligible à un extrait dans la recherche. Les autres éditeurs ne posent pas tous la même règle, et certains vont chercher la page à la volée au moment de répondre. Mais aucune condition du référencement classique ne devient inutile pour autant.
Pour aller plus loin
La vue d’ensemble de l’externalisation du référencement, du coût au choix du prestataire en passant par l’audit et le suivi : le guide de l’externalisation SEO.
Le métier, ses missions concrètes et son fonctionnement en collaborateur dédié : la fiche consultant SEO.
Vous voulez savoir ce que les moteurs de réponse disent aujourd’hui de votre entreprise ? Parlons-en.